Большинству компаний, которые меня об этом спрашивают, кластер Kubernetes не нужен. Это первое, что я говорю на созвоне, и половина разговоров на этом заканчивается к обоюдной пользе. Но когда он всё-таки нужен, дальше начинается инженерия, а не выбор между «поднять за вечер» и «купить managed». Ниже разобрано, как я собираю кластер на своём железе и что в нём закрываю: не список рекомендаций, а решения с ценой каждого.
Отдельно предупреждаю: значительная часть советов по Kubernetes, которые сейчас выдаёт поиск, устарела не на оттенок, а до неверности. Ingress-контроллер из большинства руководств закрыт и больше не получает исправлений безопасности. Флаг, который «включает шифрование секретов», может не включать ничего. Всё это проверено по первоисточникам в сентябре 2026 года, ссылки в конце.
- Сначала честный вопрос: нужен ли вам кластер Kubernetes
- В продакшене я рекомендую отдельные сервисы, а не кластер
- Дистрибутив решает, сколько операционной системы остаётся вашей
- Talos удаляет мою роль Ansible
- Почему три ноды, а не две – во второй раз
- В стойке нет балансировщика
- В марте 2026 года ingress-nginx закрыли
- Default deny, который ничего не запрещает
- В etcd лежит base64, а не шифр
- Политики переехали в ядро, а Kyverno – это ещё один сервис, который может лечь
- Четыре двери мимо контроля допуска и аудита
- GitOps – это нулевой уровень, а не деплой-тул
- Секреты: цепочка, у которой нет постоянного токена
- Дешёвые победы, которые почти никто не включает
- Что ломается на обновлениях
- Чего я сознательно не делаю
- Бенчмарк – это генератор вопросов, а не оценка
- Стек
- Почему это важно тому, кто платит
- Частые вопросы
- Две ноды надёжнее одной?
- Kubernetes шифрует секреты?
- Можно ли ещё ставить ingress-nginx?
- Нужен ли Kyverno, если политики есть в самом Kubernetes?
- Что использовать вместо Kubernetes в продакшене?
- Можно ли держать разработку и продакшн в одном кластере?
- Что проверить в своём кластере в первую очередь?
- Источники
- Нужна консультация?
Сначала честный вопрос: нужен ли вам кластер Kubernetes
Kubernetes решает задачу, которой у большинства нет: много команд катят много сервисов на общий парк машин и не должны при этом договариваться друг с другом руками. Если у вас три сервиса и одна команда, вы покупаете эту развязку по полной цене, а пользуетесь ей на проценты.
Самое полезное, что я могу сказать про размер кластера, звучит контринтуитивно: две ноды строго хуже одной. Кворум etcd считается большинством, и таблица отказоустойчивости выглядит так: одна нода переживает ноль отказов, две ноды переживают ноль отказов, три ноды переживают один. То есть вторая машина удваивает стоимость и вероятность поломки, не добавляя ни одного пережитого отказа. Она добавляет только ощущение отказоустойчивости.
Поэтому для многих клиентов честный ответ – одна нода, снапшоты etcd и конфигурация в git. Восстановление занимает минуты, а не часы, и оно проверяемо. Отказоустойчивость, которую вы ни разу не проверяли учением, отказоустойчивостью не является: это строчка в презентации. Red Hat не стесняется поставлять и поддерживать одноузловой OpenShift для продакшна на периферии, Talos включает одноузловой режим одним ключом конфигурации – значит, и вам не стыдно.
В продакшене я рекомендую отдельные сервисы, а не кластер
Если вы дочитали до этого места и всё ещё сомневаетесь, вот мой ответ по умолчанию для боевого контура: не кластер, а несколько самодостаточных сервисов и обычная отказоустойчивость под ними. Самая чистая форма сервиса – статически слинкованный бинарник на Go: он не тянет за собой рантайм, не требует базового образа, запускается юнитом systemd и обновляется заменой файла. Рядом – плавающий адрес через keepalived или слой высокой доступности гипервизора. Это весь стек.
Аргумент здесь не про моду и не про вкус, а про количество подвижных частей, которые придётся сопровождать. Кластер – это не один компонент: это сеть контейнеров, вход, контроль допуска, хранилище состояния, система доставки и агент на каждой ноде, и у каждого свой календарь обновлений и свой способ сломаться. Всё, что описано в этой статье ниже, – и есть цена владения этим набором. У бинарника с юнитом systemd отказ целиком помещается в голове: процесс жив или мёртв, порт слушается или нет, файл на месте или нет. Восстановление тоже: положить файл, перезапустить юнит.
Кластер выигрывает ровно там, где выигрывает его главное свойство: много команд катят много сервисов и не должны договариваться руками. Пока у вас десяток сервисов и одна команда, вы платите за развязку, которой не пользуетесь, и получаете взамен работу по её сопровождению. Это не осторожность, это арифметика.
И отдельно то, на чём я настаиваю жёстче всего: Kubernetes для разработчиков и Kubernetes для боевых проектов – это два разных решения, и смешивать их нельзя. В разработке кластер как раз на своём месте: окружение на каждую ветку, временные пространства имён, состояние, которое не жалко потерять, быстрый откат. Там его цена окупается скоростью команды. Боевой контур – это отдельный кластер с отдельными учётными данными, отдельной сетью и отдельным доступом, а не пространство имён в том же самом.
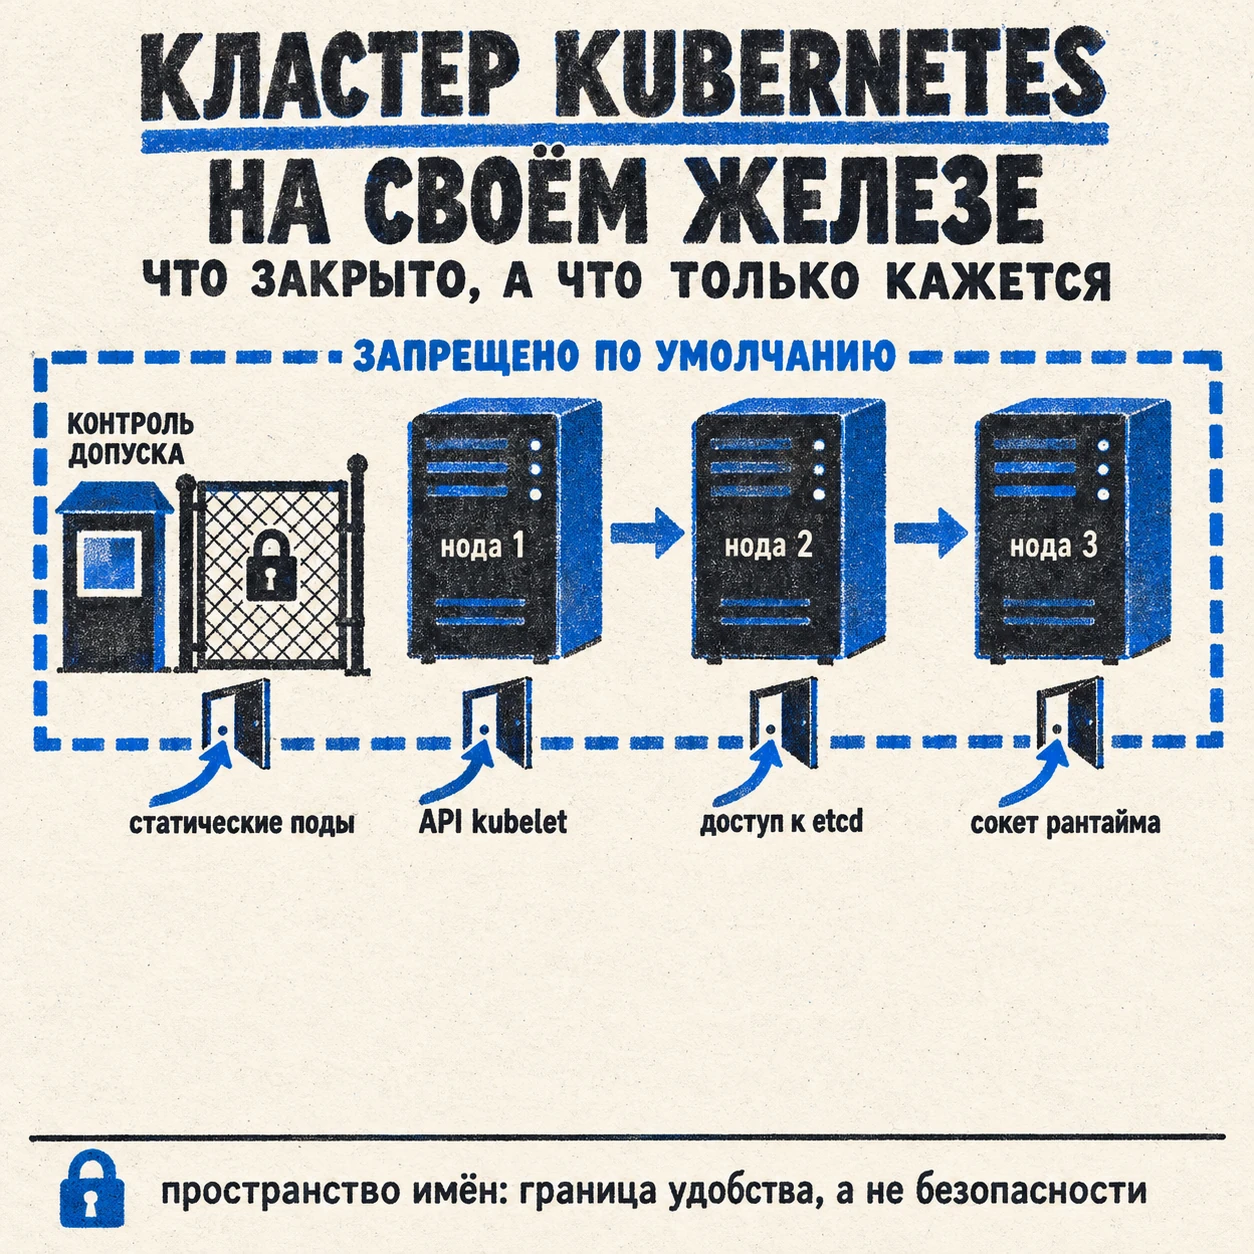
Причина техническая, а не организационная. Пространство имён – это граница удобства, а не граница безопасности: контроль допуска обходится четырьмя дверьми, о которых ниже отдельный раздел, право get на nodes/proxy про ваши пространства имён ничего не знает, а ошибка в политике системы доставки приезжает во все сразу. Проверка простая: если боевой сервис и стенд разработчика можно остановить одной и той же опечаткой в манифесте, у вас не два контура, а один.
Дистрибутив решает, сколько операционной системы остаётся вашей
Дистрибутивы Kubernetes отличаются не набором функций – по функциям они совпадают, потому что все проходят сертификацию на соответствие. Они отличаются тем, сколько операционной системы остаётся в вашем ведении.
- kubeadm поднимает управляющий слой и честно снимает с себя всё остальное: подготовку машин и сеть контейнеров он объявляет не своей задачей. Максимум контроля, максимум вашей работы.
- k3s – это весь управляющий слой как горутины в одном бинарнике. Он сертифицирован CNCF как полноценный Kubernetes, а не «урезанная версия для учёбы», и прямо декларирует, что не трогает хостовую ОС. Бинарник, к слову, весит 81,5 МБ, а не «меньше сорока», как повторяют обзоры.
- RKE2 – статические поды, профили CIS одним ключом и сборка с криптографией под федеральный стандарт. Документация проекта, правда, до сих пор говорит про FIPS 140-2, тогда как соседи переехали на 140-3.
- Talos Linux убирает операционную систему из ваших рук совсем: ни shell, ни SSH, вся машина описана одним YAML, обновления образа идут двумя разделами A/B.
- OpenShift – это платформа и контракт поддержки. За них вы платите отставанием от апстрима.
Про отставание стоит сказать отдельно, потому что «лёгкие дистрибутивы вечно отстают» – мёртвый тезис. Я сверился с релизными API 18 сентября 2026 года. Апстрим 1.37 вышел 26 августа. k3s и RKE2 выпустили свои сборки 14 сентября, Talos – в те же дни. Девятнадцать дней. OpenShift 4.22 вышел в июле и до сих пор несёт Kubernetes 1.35 – семь месяцев. Разница между девятнадцатью днями и семью месяцами и есть предмет сделки: вы покупаете не отставание, вы покупаете того, кому звонить.
Talos удаляет мою роль Ansible
Мой обычный ответ на любую инфраструктуру – описать её кодом. Кластер Proxmox, который восстанавливается из git clone, устроен именно так: каждое ручное исправление превращается в плейбук, состояние живёт в репозитории, а не в чьей-то памяти.
Talos на это отвечает неприятную вещь. В его философии написано прямым текстом: состояние машины объявляется одним манифестом, без скриптов и процедурных шагов, и без систем управления конфигурацией, которые надо сопровождать. Это не комплимент моему методу. Это вызов ему.
Вывод, к которому я пришёл, простой и не в пользу единообразия: Ansible прав для изменяемой ОС, которой я владею, и не нужен для ОС, куда нельзя зайти. Proxmox – мой, у него есть shell, пакеты, состояния, которые дрейфуют, и там роль Ansible окупается каждый день. У Talos дрейфовать нечему: нет shell, нет пакетов, нет способа что-то подкрутить руками между релизами. Автоматизировать конфигурацию там нечего – конфигурация и есть манифест. Два слоя, два ответа.
У этого выбора есть цена, и её надо назвать вслух раньше, чем это сделает читатель. В три часа ночи, когда нода в состоянии, которого нет в API, на Talos у меня не будет ни strace, ни tcpdump, ни возможности просто зайти и посмотреть. Останутся talosctl dmesg, логи и пакет диагностики. И останется то же решение, которым я закрываю такие ситуации на Proxmox: не чинить, а переналить и прогнать автоматизацию заново.
Почему три ноды, а не две – во второй раз
Этот заголовок я уже писал – этажом ниже, про кворум Corosync. Аргумент дословно тот же, меняются только цифры: большинство нужно, чтобы принимать решения однозначно, две ноды большинства не образуют, третья ломает симметрию и делает победителя определённым.
Интереснее то, о чём в общих статьях не пишут, потому что для этого надо смотреть на конкретный парк. Если поставить кластер Kubernetes из трёх нод поверх кластера Proxmox из трёх нод, вы получите две независимые системы кворума, которые отказывают вместе. Потеря одной физической машины стоит одного голоса в каждой. Это не катастрофа – обе системы переживают потерю одного члена. Но это значит, что запас прочности не складывается, а совпадает, и планировать обслуживание надо как для одной системы, а не как для двух.
Внешний etcd на отдельных машинах эту связку разрывает. Я его не ставлю: шесть машин, чтобы защитить хозяйство из трёх, – это решение проблемы, которой у меня нет.
В стойке нет балансировщика
Почти все руководства по Kubernetes написаны из облака, и это видно в одном месте: сервис типа LoadBalancer там просто работает. На своём железе его должен кто-то предоставить, и это самая недописанная часть темы.
- MetalLB – самый известный ответ. Ему девять лет, и он до сих пор не дошёл до версии 1.0.
- Cilium с выдачей адресов и L2-анонсами – в статусе беты, переключение занимает десяток-другой секунд на обновление ARP, адрес анонсирует одна выбранная нода, балансировки между нодами при этом нет.
- BGP до настоящего маршрутизатора – правильный ответ, если маршрутизатор ваш и вы готовы держать на нём конфигурацию как часть инфраструктуры.
Учебник отдельно требует поставить перед API-сервером HAProxy с keepalived. Здесь я делаю ровно тот же ход, что с Thunderbolt вместо десятигигабитного свитча: отказываюсь от дорогого стандартного компонента, разобравшись, зачем он рекомендован. Talos держит на каждой ноде локальный балансировщик к управляющему слою, k3s решает то же самое клиентским балансировщиком внутри агента. Внутрикластерный трафик тогда не зависит от внешней коробки и переживает её выключение. Снаружи балансировщик всё ещё нужен – но теперь он обслуживает только вход администратора, а не жизнь кластера.
В марте 2026 года ingress-nginx закрыли
Это редкий случай, когда учебный ответ не стал хуже, а перестал существовать. Репозиторий ingress-nginx переведён в архив только для чтения. Заявление руководящего комитета и комитета по реагированию на инциденты не оставляет места толкованиям: больше не будет ни релизов, ни исправлений ошибок, ни закрытия уязвимостей. В том же заявлении сказано, что речь идёт о критической инфраструктуре примерно половины облачных окружений.
Дальше ещё интереснее. InGate – замена, которую официально готовила профильная рабочая группа, – закрыт, не выйдя ни разу; его репозиторий тоже в архиве. А сам Ingress API объявлен замороженным: это написано на странице концепции в документации Kubernetes, вместе с рекомендацией использовать Gateway.
Здесь легко запутаться, и путаются многие: ingress-nginx и NGINX Ingress Controller – это два разных продукта. Умер общественный проект. Коммерческий контроллер F5 жив и выпускается до сих пор. Если вы читаете инструкцию и не понимаете, о каком из двух речь, вы не поймёте и того, какой совет получили.
Про миграцию надо знать главное: она не автоматическая. Официальная утилита перевода прямо заявляет, что не переносит аннотации, – а в аннотациях живёт всё интересное: ограничения частоты, внешняя авторизация, переписывание путей, вставки конфигурации. Скелет маршрутов вы получите машинно, политику придётся писать руками.
И отдельная ловушка, из-за которой миграция ломается молча: маршрутизация ingress-nginx ведёт себя не так, как написано в манифестах. При включённых регулярных выражениях совпадение становится префиксным и нечувствительным к регистру, так что путь вида /[A-Z]{3} поймает и строчные буквы, и всё, что идёт дальше. Перенесёте правила буквально – получите другое поведение при тех же файлах.
Default deny, который ничего не запрещает
Сетевые политики Kubernetes – это декларация намерения, а не механизм. Применяет их сеть контейнеров. Если ваш CNI их не реализует, происходит худшее из возможного: kubectl apply проходит успешно, kubectl get netpol показывает политику, а трафик ходит как ходил. На Flannel это ровно так и работает.
Второе, что стоит знать наизусть: трафик к поду и от пода со своей же ноды разрешён всегда, и это записано в спецификации как исключение, а не как баг реализации. То есть «у нас включён default deny» – утверждение, которое нужно проверять тестом, а не конфигурацией. Правильная формулировка задачи звучит так: показать трафик, который должен быть заблокирован, и убедиться, что он заблокирован. Всё остальное – вера.
Ещё одна мина для тех, кто читает статьи старше года: административные политики уровня кластера переименованы. Того вида ресурсов, который приводится в большинстве примеров, больше нет под прежним именем.
В etcd лежит base64, а не шифр
Документация Kubernetes формулирует это без дипломатии: по умолчанию API-сервер складывает в etcd открытые представления объектов, без шифрования на диске. Секрет в Kubernetes – это не защищённое хранилище, это объект с пометкой «обращайтесь осторожно».
Дальше три ловушки подряд, и каждая встречается в статьях из первой десятки выдачи.
- Конфигурация, которая выглядит как шифрование и им не является. Если в списке провайдеров первым стоит
identity, шифрования нет – при том, что флаг передан и всё запускается. - Алгоритм, который советуют почти все и не советует документация. Провайдер
aescbcпомечен как нерекомендуемый из-за уязвимости CBC к атакам на дополнение. - Включение не шифрует то, что уже лежит. Старые секреты остаются открытыми, пока их физически не перезапишут. Это отдельная операция, а не следствие правки конфига.
И главное – про честность метода. На своём железе без облачного модуля управления ключами локальное шифрование во многом театр, и документация говорит это сама: ключи лежат в открытом YAML на том же хосте, что и etcd, поэтому защита работает против кражи диска etcd и не работает против компрометации хоста. Я это включаю – но называю тем, что оно есть: одним слоем против одного сценария. Настоящий ответ лежит в стороне и описан отдельно: секреты выдаются на время, а не хранятся, а мастер-ключи живут в аппаратном модуле.
Политики переехали в ядро, а Kyverno – это ещё один сервис, который может лечь
Рефлекс «первым делом ставим Kyverno или Gatekeeper» сформировался тогда, когда в Kubernetes не было своего языка политик. Сейчас он есть: проверяющие политики на CEL стабильны с 1.30, изменяющие – с 1.36, и оба типа включены в список плагинов допуска по умолчанию. Для простых правил внешний движок больше не нужен.
Отдельно отмечу то, что ложится ровно на мой подход к инфраструктуре: в 1.37 появились политики допуска, заданные файлами на диске. Они не хранятся в etcd, загружаются до того, как API-сервер начал обслуживать первый запрос, и их нельзя удалить никакими правами. Это закрывает окно на старте кластера, о котором молчат все статьи про «политики как код». Функция включена по умолчанию, но пока в статусе беты – в продакшн я её беру с этой оговоркой.
Про внешний движок надо знать риск, которого нет в руководствах по установке. Kyverno по умолчанию настраивает свои перехватчики в режиме отказа – это безопаснее с точки зрения политики и опаснее с точки зрения доступности. Если перехватчик недоступен во время перезапуска управляющего слоя, не создаётся ничего. Включая сам Kyverno. Выход из такого состояния – руками удалять объекты конфигурации перехватчиков, и делать это вы будете ночью. Встроенные политики так отказать не могут, потому что выполняются внутри процесса API-сервера.
Если вы всё же ставите Kyverno, обратите внимание на его собственную смену API: тип ресурса, который используется во всех руководствах в интернете, объявлен устаревшим в пользу новых типов на CEL. Писать новые политики сегодня стоит сразу на них.
Четыре двери мимо контроля допуска и аудита
Контроль допуска работает на API-сервере. Всё, что до API-сервера не доходит, его не проходит – и в журнале аудита тоже не появляется. Дверей четыре: статические поды, которые kubelet запускает из файла на диске; собственный API самого kubelet; прямой доступ к etcd; сокет рантайма контейнеров на ноде.
Из практических следствий самое недооценённое вот это: право get на nodes/proxy – это не право на чтение. Оно даёт выполнение команд в любом контейнере на ноде. Такое право регулярно выдают агентам мониторинга «чтобы собирать метрики», и оно означает совсем не то, на что похоже. Начиная с 1.36 есть нормальный выход: детализированная авторизация kubelet, где агенту выдаются узкие права вместо одного широкого.
GitOps – это нулевой уровень, а не деплой-тул
Инструмент, который имеет право менять что угодно в кластере, по уровню критичности стоит рядом с гипервизором, а не рядом с CI. Две истории 2026 года показывают это лучше любых рассуждений.
В июле опубликовали цепочку удалённого выполнения кода в Argo CD: внутренний компонент, отвечающий за сборку манифестов, слушает свой порт без аутентификации, потому что он «внутренний». Внутри кластера «внутренний» означает «доступный любому поду». Сообщили об этом ещё в январе 2025 года. Исправления в коде на момент публикации не было; единственное публичное лечение – смена умолчаний в Helm-чарте, который наконец стал создавать сетевые политики. Если вы ставили Argo CD чартом и переносили свой values.yaml между версиями, вы, скорее всего, всё ещё без них. Проверяется это за минуту: версия чарта и наличие объектов сетевых политик в пространстве имён.
В августе своё получил и Flux: политика, которая ставится по умолчанию вместе с инструментом, пускала входящий трафик к контроллеру уведомлений из любого пространства имён. Тезис «pull-модель избавляет от сетевых политик» на этом закрывается.
Выбор между Argo CD и Flux я давно делаю не по таблице возможностей – там паритет. Ось другая: чей это код и под какой лицензией он крутится у меня. Ядро Flux – Apache-2.0 внутри CNCF, но весь современный обвес живёт в вендорской организации под AGPL-3.0. У Argo CD интерфейс лежит внутри самого проекта CNCF. Это ровно тот тип рассуждения, что и с выбором дистрибутива: не «что лучше в обзоре», а что я готов держать у себя и чем за это плачу.
И ещё одна вещь, которая ломается на ровном месте при обновлении: переход Argo CD на свежую ветку меняет движок шаблонов на Helm 4 для всех ваших чартов, а закрепление старой версии в манифесте приложения просто игнорируется. Helm 3 получает только исправления безопасности до февраля 2027 года.
Секреты: цепочка, у которой нет постоянного токена
Здесь надо начать с неприятного: все популярные подходы – запечатанные секреты, шифрование файлов в репозитории, операторы внешних секретов – в конце кладут в etcd обычный открытый объект. Разница между ними в том, кто может прочитать источник, а не в том, что в etcd чисто. Единственный путь без материализации объекта требует драйвера с эфемерным томом и коммерческой лицензии.
Это надо принимать осознанно и говорить вслух. Я принимаю: сверху лежит шифрование на диске, права разграничены, руками к данным никто не ходит. А интересное начинается там, где можно убрать постоянный доступ.
Свежая возможность, которой почти полтора месяца от роду: контроллер Flux может обменять свой служебный токен Kubernetes на короткоживущий токен OpenBao и расшифровать файлы через движок транзитного шифрования – без единого постоянного секрета в кластере. Ключ при этом физически не покидает хранилище, а мастер-ключи самого хранилища лежат в аппаратном модуле. Это продолжение того же тезиса, который я уже применял этажом ниже: доступ выдаётся на время, постоянного доступа нет.
Предупреждение тем, кто ставит OpenBao с аппаратным ключом: в следующей мажорной версии из ядра убирают распространение через аппаратные модули и вендорские механизмы автоматического распечатывания – они переезжают в плагины, а файловое хранилище удаляется совсем. Для установки с аппаратным ключом это не «необязательное обновление», а запланированная поломка, к которой надо готовиться заранее.
Дешёвые победы, которые почти никто не включает
Большинство руководств по защите предлагает править каждый манифест приложения. Это работает ровно до первой команды, которая про ваши правила не знает. Настройки уровня ноды и кластера надёжнее, потому что их нельзя забыть в новом сервисе.
- Профиль ограничения системных вызовов по умолчанию на уровне kubelet. Один ключ в конфигурации ноды применяет его ко всем подам, без правки описаний.
- Ограничение того, что нода может менять в API. Один из плагинов допуска, который kubeadm ставит сам, а собранные вручную кластеры часто теряют.
- Сужение анонимного доступа до проверок живости вместо выключателя «всё или ничего».
И ещё одна вещь, которую стоит знать про стандарты безопасности подов, потому что на ней строят ложное чувство защищённости: режим принуждения не применяется к развёртываниям и заданиям – только к получившимся подам. Предупреждения и аудит на уровне рабочих нагрузок работают, принуждение – нет. Поэтому «мы включили restricted» не означает, что развёртывание не проедет: оно проедет, а под не создастся, и выяснится это в момент выкатки.
Что ломается на обновлениях
Абстрактные риски в Kubernetes обсуждают много, а ломается обычно день обновления. Вот что стоит держать в календаре.
- Сертификаты kubeadm живут ровно год. Обновляются автоматически только при апгрейде кластера. Это самый частый способ тихо убить собранный руками кластер: он просто перестаёт пускать через год после установки.
- Обязательное монтирование с метками безопасности стало поведением по умолчанию в 1.37 с явным предупреждением, что это может сломать существующие нагрузки.
- Обновление etcd с 3.5 на 3.6 через неправильную версию способно воскресить удалённых членов кластера и разрушить кворум. Нужно сначала подняться до исправленной версии в ветке 3.5, а уже потом идти дальше.
- В etcd 3.7 удалили все экспериментальные флаги. Шаблоны инфраструктуры как кода, которые их выставляют, просто не запустятся.
- Команды снапшотов переехали. Восстановление из резервной копии делается другой утилитой – ваш рунбук, написанный до 3.6, неверен.
Отдельно про то, чего не произошло, хотя об этом написали многие. Поддержку первой версии механизма контрольных групп в 1.36 не удаляли – я скачал журнал изменений и проверил сам. Она объявлена устаревшей раньше, и kubelet по умолчанию отказывается стартовать на такой ноде, но удаления не было. И nftables не стал режимом по умолчанию для сетевого прокси, вопреки половине обзоров: он стабилен, но умолчанием остаётся прежний механизм, а на удаление отправлен другой.
Чего я сознательно не делаю
- Не беру OpenShift на малый парк. Это покупка отставания в полгода с лишним и лицензии ради контракта поддержки, который в таком масштабе не нужен.
- Не ставлю внешний etcd. Шесть машин ради защиты трёх.
- Не ставлю сервисную сетку на три ноды. То, ради чего её обычно берут – взаимная аутентификация между сервисами, – закрывается на уровне сети контейнеров без врезки прокси в каждый под. Без сетки я остаюсь без политик уровня приложения, повторов и размыкателей на уровне запроса и без общей идентичности между кластерами. Мне это не нужно; если вам нужно – это и есть повод её ставить.
- Не строю управляющую плоскость над кластерами. Хорошие инструменты для этого есть, но три ноды ими не управляют.
- Не полагаюсь на политики по доменным именам. Они всё ещё экспериментальны.
- Не использую механизм прокси, отправленный на удаление, даже там, где он пока быстрее.
Бенчмарк – это генератор вопросов, а не оценка
Отраслевой бенчмарк безопасности Kubernetes полезен, но с ним связано заблуждение, которое стоит денег. Свежая редакция вышла в июне 2026 года и покрывает версии 1.34 и 1.35. Kubernetes 1.37 вышел в августе. То есть для актуального кластера бенчмарка просто нет, и инструмент проверки будет оценивать вас по документу, написанному под предыдущие релизы.
Отсюда правильное употребление: брать из него список вопросов, а не итоговый балл. Целые разделы про права на файлы управляющего слоя на управляемом кластере к вам не относятся вовсе, а на кластере из kubeadm выполняются сами. Команды сжигают на них недели, потому что гонятся за процентом соответствия. При этом собственная модель угроз у небольшого кластера другая, чем предполагает чек-лист: у меня на своём железе нет облачной службы метаданных, из которой крадут учётные данные, зато есть вещи, которых нет в чек-листе.
Стек
- Kubernetes: оркестратор; актуальная ветка 1.37, поддерживаются три минорных релиза.
- Talos Linux и k3s: два ответа на вопрос, сколько ОС остаётся вашей.
- etcd: хранилище состояния кластера; отдельные диски, снапшоты, осторожность на мажорных переходах.
- Cilium: сеть контейнеров, сетевые политики и выдача адресов на своём железе.
- Gateway API: вход в кластер после заморозки Ingress; ставится отдельно от ядра и версионируется вами.
- cert-manager: сертификаты; срок жизни короткий, писем о продлении больше не присылают, следить за истечением теперь ваша работа.
- OpenBao: секреты и транзитное шифрование; мастер-ключи в аппаратном модуле.
- Flux или Argo CD: доставка из репозитория; выбирается по лицензии и сопровождению, а не по интерфейсу.
- Ansible: слой ниже кластера, там где ОС изменяемая и моя.
Почему это важно тому, кто платит
Кластер Kubernetes – это не строка в бюджете на инфраструктуру, это обязательство на годы. Вы берёте на себя три релиза в год, каждый с окном поддержки около четырнадцати месяцев, из которых последние два – только безопасность. Вы берёте компонент, который может закрыться, как закрылся входной контроллер у половины индустрии. Вы берёте инструмент доставки, который имеет право менять в кластере всё.
Отсюда два практических вывода для того, кто подписывает счёт. Первый: не берите кластер, если задача решается проще – деньги уходят не на железо, а на внимание команды, и это самая дорогая статья. Второй: если кластер уже есть, самая полезная трата – не новый инструмент безопасности, а ревизия того, что у вас уже работает по умолчанию. Открытые секреты в etcd, политики, которые ничего не запрещают, сетевой доступ к внутренним компонентам системы доставки и права, которые выглядят как чтение, а означают выполнение, – всё это уже включено и ничего не стоит починить, кроме времени.
Частые вопросы
Две ноды надёжнее одной?
Нет, строго наоборот. Кворум считается большинством: одна нода переживает ноль отказов, две – тоже ноль, три – один. Вторая машина удваивает стоимость и число возможных поломок, не добавляя ни одного пережитого отказа.
Kubernetes шифрует секреты?
По умолчанию нет: API-сервер складывает в etcd открытые представления объектов. Включение шифрования на диске не трогает уже существующие секреты, пока их не перезапишут, а если в списке провайдеров первым стоит identity, шифрования не будет вовсе.
Можно ли ещё ставить ingress-nginx?
Нет. В марте 2026 года проект закрыт, репозиторий переведён в архив, новых исправлений безопасности не будет. Сам Ingress API объявлен замороженным, а замена от рабочей группы закрыта, не выйдя. Коммерческий контроллер NGINX от F5 – это другой продукт, и он жив.
Нужен ли Kyverno, если политики есть в самом Kubernetes?
Для простых правил не нужен: проверяющие политики на CEL стабильны с версии 1.30, изменяющие с 1.36, оба типа включены по умолчанию. Внешний движок добавляет возможности и одновременно новый режим отказа: его перехватчики по умолчанию настроены так, что при их недоступности не создаётся ничего.
Что использовать вместо Kubernetes в продакшене?
Несколько самодостаточных сервисов и обычную отказоустойчивость под ними: статически слинкованный бинарник, юнит systemd, плавающий адрес через keepalived или слой высокой доступности гипервизора. Кластер оправдан, когда много команд катят много сервисов и не должны договариваться руками; на десяток сервисов и одну команду вы платите за развязку, которой не пользуетесь.
Можно ли держать разработку и продакшн в одном кластере?
Нет. Пространство имён – это граница удобства, а не граница безопасности: контроль допуска обходится статическими подами и собственным API kubelet, право get на nodes/proxy про пространства имён ничего не знает, а ошибка в политике доставки приезжает во все сразу. Боевой контур – отдельный кластер с отдельными учётными данными, сетью и доступом.
Что проверить в своём кластере в первую очередь?
Четыре вещи: включено ли шифрование на диске и не стоит ли identity первым; работают ли сетевые политики на вашей сети контейнеров или молча игнорируются; есть ли сетевые политики вокруг компонентов системы доставки; и кому выдано право get на nodes/proxy, потому что это не чтение, а выполнение команд на ноде.
Источники
- Релизы и окна поддержки Kubernetes, анонс 1.37.
- Шифрование данных в etcd: умолчания, провайдеры и ограничения локальных ключей.
- Уход ingress-nginx и заявление руководящего комитета.
- Заморозка Ingress API и документация Gateway API.
- Сетевые политики: зависимость от CNI и исключение для своей ноды.
- Допуск по стандартам безопасности подов: почему принуждение не применяется к рабочим нагрузкам.
- Политики допуска на CEL в ядре Kubernetes.
- Эксплуатация etcd: дефрагментация, сжатие, снапшоты.
- CIS Kubernetes Benchmark и kube-bench с таблицей соответствия версий.
- Философия Talos Linux и документация k3s.
Нужна консультация?
Если вы решаете, нужен ли вам кластер вообще, или у вас он уже есть и хочется понять, что в нём открыто по умолчанию, – запишитесь на разговор. Разберём вашу задачу и честно скажем, где Kubernetes окупается, а где он дороже пользы. Смежные материалы: кластер Proxmox как код, Zero Trust на практике, SIEM на открытом ядре.