Когда в кластере появляется третья нода, почти сразу возникает вопрос про распределённое хранилище, и обычно он звучит как «Ceph или ZFS». В панели Proxmox Ceph ставится за несколько кликов, и соблазн понятен: общий диск на все машины, живая миграция без ожидания, никаких интервалов синхронизации. На моём кластере из трёх нод Ceph нет. Данные между нодами переезжают репликацией ZFS, копии уходят на отдельный сервер резервного копирования.
Ниже разобрано, почему выбор именно такой, чего он стоит и при каком размере парка я был бы неправ. Сразу оговорюсь, чего в статье не будет: я не называю время восстановления, потому что прогонов восстановления с секундомером у меня нет, а выдумывать такие числа нельзя. Рекомендации производителей сверены по документации Ceph и Proxmox на 24 сентября 2026 года.
- Короткий ответ: на трёх нодах я выбираю репликацию ZFS
- Ceph стоит дороже сетью, чем дисками
- Два кворума на одних и тех же трёх машинах
- Что даёт репликация ZFS и чего не даёт
- Потеря данных измеряется интервалом репликации
- Файлам нужна своя репликация
- Копия, которая спит между окнами
- Две аварии, которые научили больше документации
- Полторы тысячи строк bash это уже программа
- Копию проверяют после каждого прогона, а не когда она понадобилась
- Образ, который я не собираю
- С какого размера парка я был бы неправ
- Чего я сознательно не делаю
- Стек
- Почему это важно тому, кто платит
- Частые вопросы
- Ceph или ZFS для кластера Proxmox из трёх нод?
- Сколько данных теряется при репликации ZFS?
- Можно ли использовать реплику вместо резервной копии?
- Хватит ли для Ceph полносвязной сети через Thunderbolt?
- С какого размера кластера стоит переходить на Ceph?
- Нужен ли Packer для небольшого кластера?
- Источники
- Нужна консультация?
Короткий ответ: на трёх нодах я выбираю репликацию ZFS
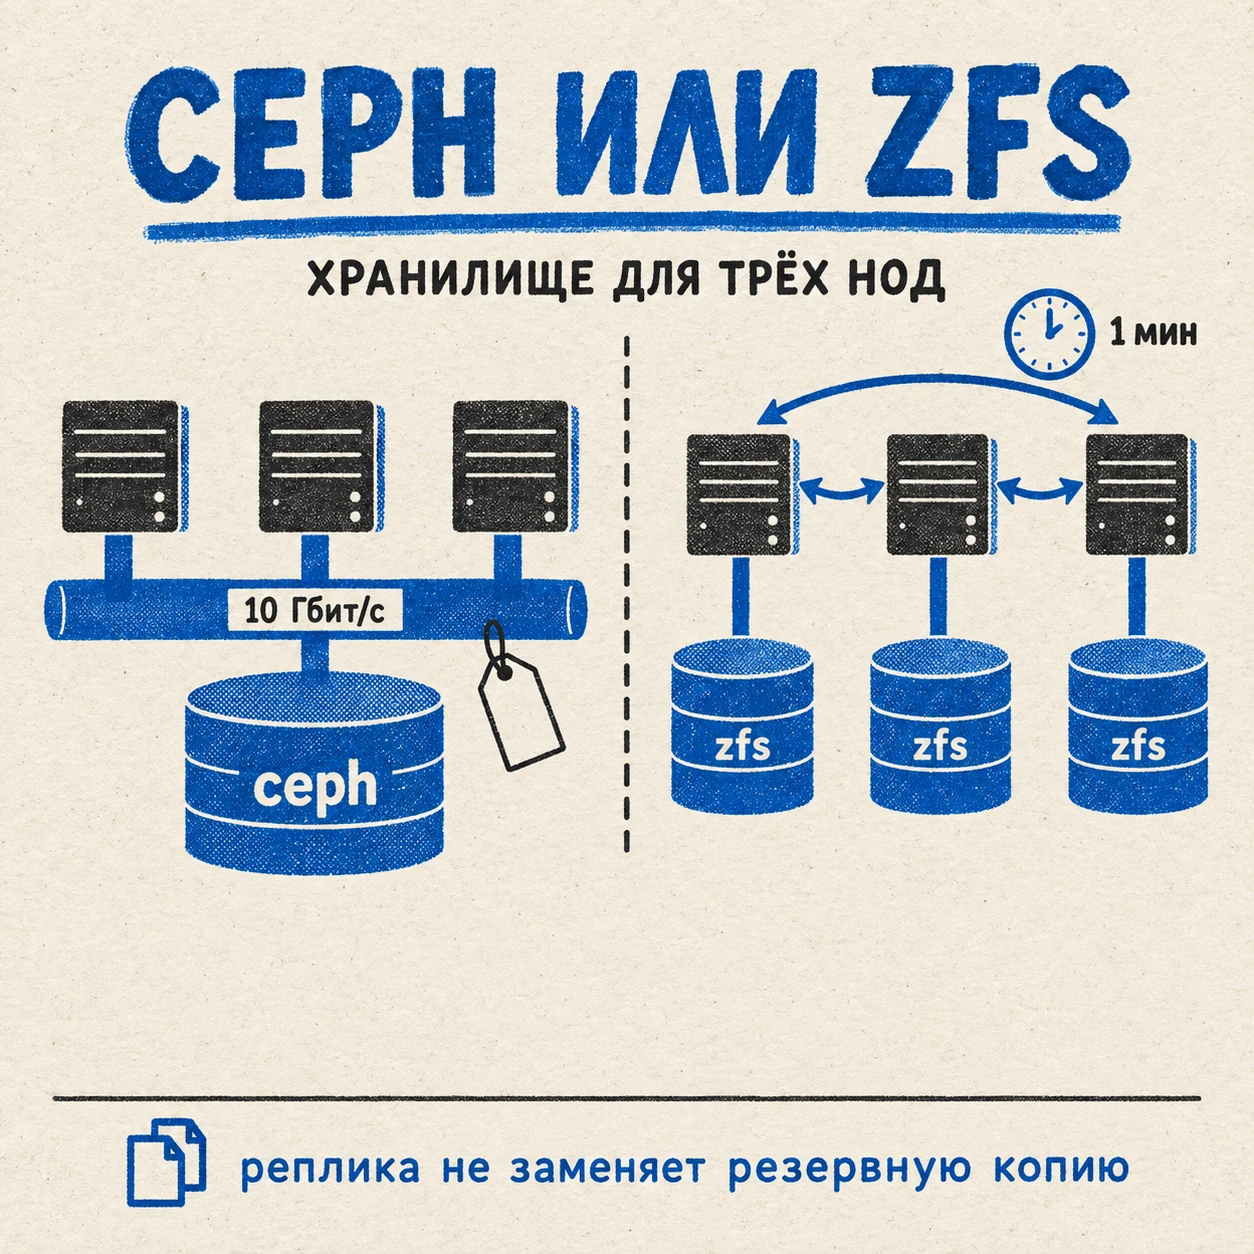
У каждой ноды свои локальные диски под ZFS. Виртуальные машины и контейнеры реплицируются на соседние ноды по расписанию, и если нода падает, машина поднимается на другой из последней реплики. Отдельно от этого работают резервные копии на выделенный сервер, и отдельно синхронизируются файловые шары.
Цена этого выбора одна, и её надо назвать сразу: репликация асинхронная. Всё, что изменилось после последней синхронизации, при отказе ноды теряется. Документация Proxmox пишет об этом прямо: высокая доступность вместе с репликацией хранилища допустима, но между последней синхронизацией и моментом отказа возможна потеря данных. Ceph такой потери не допускает, потому что пишет на несколько нод сразу. Весь дальнейший разговор о том, стоит ли это свойство того, что за него платят.
Ceph стоит дороже сетью, чем дисками
Документация Ceph просит сеть не медленнее 10 Гбит/с, причём и между узлами хранилища, и между ними и клиентами. Для заметной нагрузки там же советуют 25 Гбит/с. Proxmox формулирует жёстче: не меньше 10 Гбит/с, и эта сеть должна использоваться только под трафик Ceph. Один NVMe-диск по их же оценке способен сам загрузить десятигигабитный канал.
То есть главная статья расходов распределённого хранилища вовсе не диски. Это выделенная быстрая сеть, отдельная от той, по которой ходят пользователи и управление, а в малом офисе ещё и свитч под неё, который тоже может отказать.
Для кластеров от трёх до пяти нод без такого свитча Proxmox предлагает полносвязную сеть: ноды соединяются друг с другом напрямую. Именно так я и сделал, соединив ноды кабелями Thunderbolt. И вот что показал замер. Линк согласовался на 20 Гбит/с, но только по одной линии из двух: у нод контроллеры разных поколений. В первую секунду теста после настройки буферов было 6,6 Гбит/с, а дальше скорость падала до 0,94 Гбит/с устойчиво при почти миллионе повторных передач. Для репликации ZFS по расписанию этого хватает. Для хранилища, которое пишет каждую операцию на три ноды одновременно, это в десять раз меньше рекомендованного минимума.
Решение записано и в конфигурации: репозиторий пакетов Ceph в роли развёртывания кластера явно выключен. Это не забытая настройка, а зафиксированный отказ.
Два кворума на одних и тех же трёх машинах
Про то, почему нод три, а не две, я уже писал дважды: в статье про Kubernetes и в статье про Proxmox. Здесь тот же аргумент поворачивается другой стороной.
У кластера Proxmox свой кворум: большинство нод должно видеть друг друга, чтобы кластер принимал решения. У Ceph свой: мониторы тоже договариваются большинством. Поставьте оба на одни и те же три машины, и вы получите два кворума, которые отказывают вместе. Потеряли одну машину, и оба теряют по голосу. Оба переживут потерю одной ноды, но запас прочности у них не складывается, а совпадает. Второй отказ уронит и кластер, и хранилище одновременно, и восстанавливать придётся оба сразу.
Репликация ZFS такого второго кворума не добавляет. У каждой ноды свои данные, реплики просто лежат на соседях. Если кластер потерял кворум, данные никуда не делись, они на дисках каждой ноды, и их можно поднять руками.
Что даёт репликация ZFS и чего не даёт
Репликация в Proxmox работает поверх снимков ZFS: на соседнюю ноду уходит только разница с прошлого раза, поэтому передача дешёвая и её можно запускать часто. Минимальный интервал одна минута, максимальный раз в неделю. Расписание задаётся в формате календарных событий systemd.
- Даёт: быстрый подъём машины на соседней ноде при отказе, живую миграцию, при которой копируется только свежая разница, и независимость от сети в момент записи. Машина пишет в свой локальный диск на скорости диска.
- Не даёт: синхронной записи. Потеря данных при отказе ноды ограничена интервалом, но не нулём.
- Не даёт: защиты от логической ошибки. Удалённый файл или испорченная база аккуратно реплицируются на соседа при следующем запуске. Для этого нужны резервные копии, а не реплика.
Последний пункт путают чаще всего. Реплика это вторая копия текущего состояния, со всеми его ошибками. Резервная копия это состояние на прошлый момент. Реплика защищает от смерти железа, копия защищает от смерти данных, и одно не заменяет другое.
Потеря данных измеряется интервалом репликации
Интервал репликации это не техническая настройка, а ответ на вопрос «сколько последних минут работы мы готовы потерять при отказе железа». Этот вопрос задаётся бизнесу, а не выставляется по умолчанию.
Для внутреннего сервиса, где за последние пятнадцать минут изменилась пара записей, пятнадцать минут нормально. Для базы с платежами неприемлема и минута, и тогда вопрос не в интервале, а в том, что такой базе нужна репликация на уровне самой базы данных, а не на уровне дисков. Распределённое хранилище эту проблему тоже решает, но ценой, о которой выше.
И честная оговорка про вторую половину этого разговора. Время восстановления, то есть сколько займёт подъём после отказа, у меня не замерено ни разу с секундомером. Поэтому здесь его нет. Кто называет время восстановления без прогона, называет надежду.
Файлам нужна своя репликация
Виртуальные машины и файловые шары живут по разным законам. Машину реплицируют целиком снимком диска. Файлы, с которыми работают люди, удобнее синхронизировать на уровне файлов: тогда любой узел видит одно и то же и может раздавать шары сам.
Для этого работает Syncthing: изменения доходят до соседних узлов за две–пять секунд, и у синхронизации есть собственная история версий. Пользователи шар описаны в одном файле, который синхронизируется вместе с данными, а наблюдатель за изменениями применяет конфигурацию на каждом узле сам. Правка на любом узле становится правкой везде, и нет состояния, при котором на одной ноде пользователь есть, а на другой нет.
У этого слоя та же природа, что у реплики машин: история версий спасает от случайной правки, но не от того, что испорченный файл разъехался по всем узлам. От этого защищает только резервная копия. Про то, как устроена раздача резервных копий Time Machine с такого хранилища, я писал отдельно.
Копия, которая спит между окнами
Резервные копии уходят на отдельный сервер, а их хранилище большую часть суток спит: диски просыпаются под окно копирования и засыпают после него. Как это устроено и сколько это экономит, подробно описано в главе про бэкапы статьи про кластер Proxmox, пересказывать не буду. Здесь важнее то, что туда не вошло: две аварии, которые случились именно из-за этого цикла сна и пробуждения.
Две аварии, которые научили больше документации
Январь 2026: машины остались заблокированными. Во время копирования система резервного копирования ставит блокировки на машины и контейнеры и снимает их, когда копия готова. Проблема возникла на стыке: копирование закончилось, и сразу после этого диски хранилища копий ушли в сон. На части машин блокировки не успели сняться. Последствия были неприятнее, чем звучит: такую машину нельзя ни запустить, ни остановить, ни мигрировать, ни снять с неё снимок, а интерфейс просто показывает «заблокировано». Вывод: перед сном хранилища копий блокировки снимаются явно, не полагаясь на то, что их снимет процесс, который уже закончился.
Февраль 2026: пулы видны, но не подключены. После пробуждения дисковый бокс поднимался, диски раскручивались, ZFS их видел, а копирование падало сразу с ошибкой, что пул не импортирован. Разгадка была в состояниях. Код пробуждения умел восстанавливать пулы в состоянии «приостановлен», то есть пулы, которые были подключены и потеряли устройства. А пулы после сна оказывались в состоянии «доступен»: система их обнаружила, но не подключила. Для кода это было одно и то же, для ZFS разные вещи. Теперь пулы после пробуждения импортируются явно, по уникальному идентификатору, а не по имени.
Общий урок у обеих аварий один: «диски проснулись» и «хранилище готово» это разные утверждения. Между ними лежат состояния, которых в голове автора скрипта не было. Проверять надо не то, что шаг выполнился, а то, что система пришла в нужное состояние.
Полторы тысячи строк bash это уже программа
Управление циклом копирования начиналось как скрипт и выросло до полутора тысяч строк bash в одном файле. На этом размере у bash начинаются проблемы, которые не видны в коротких сценариях.
Самая коварная, на которую я наступил: в режиме set -euo pipefail, который все советуют ради надёжности, выражение ((count++)) при нулевом счётчике завершает скрипт. Постфиксный инкремент возвращает старое значение, ноль в арифметике bash означает «ложь», код возврата становится единицей, и строгий режим честно выходит. Режим, который включают ради надёжности, убивает скрипт на первом же увеличении счётчика с нуля. Ни ошибки, ни сообщения, просто конец.
К этому добавились испорченные символы в журналах и отсутствие проверки конфигурации до запуска. Поэтому существует версия на Python: около тысячи двухсот строк в девяти модулях, с проверкой конфигурации, структурированными журналами и тестами, включая прогоны полного цикла сна и пробуждения. Она пока в статусе прототипа, а в работе стоит версия на bash. Я пишу об этом прямо, потому что переписанное и развёрнутое это не одно и то же.
Копию проверяют после каждого прогона, а не когда она понадобилась
У резервного копирования есть неприятное свойство: его ошибки проявляются в тот момент, когда копия нужна. Поэтому после прогона идёт отдельная проверка по списку: не осталось ли блокировок, в каком состоянии хранилище копий, что именно попало в копию.
Последний пункт важнее, чем кажется. Копия машин это ещё не копия кластера. Отдельно сохраняется конфигурация самого кластера, сети, служб и скриптов, и вместе с ней генерируется сценарий восстановления и опись того, что лежит в копии. Прежний скрипт, который делал копию с одной ноды, при разборе был признан негодным: он давал ощущение, что кластер сохранён, а сохранял одну машину.
Образ, который я не собираю
Рядом с хранилищем всегда всплывает второй вопрос: собирать ли эталонные образы машин, например через HashiCorp Packer, чтобы новая нода или машина появлялась из готового шаблона. Решение у меня записано 23 июня 2026 года: для двух–трёх хостов не собираю.
Логика простая. Шаблон образа окупается, когда машин много и они одинаковые. Когда хостов два или три, их установка руками занимает минут двадцать на каждый, а автоматизация установки ради них стоит дороже, чем сэкономит. Поэтому файл автоматической установки лежит в репозитории ради воспроизводимости и аварийной переустановки, настройка хоста идёт через Ansible, а виртуальные машины создаются через Terraform. Код есть там, где он окупается, и нет там, где руками быстрее. Подробно эта развилка разобрана в статье от голого железа до боевого сервера.
Отдельная мелочь, которую полезно знать до выбора: Packer, как и Vault, распространяется под Business Source License, лицензиаром сейчас значится IBM. Для сборки своих образов это ничего не запрещает, но зависимость от условий чужой лицензии стоит держать в голове.
С какого размера парка я был бы неправ
Отказ от Ceph не принцип, а арифметика конкретного кластера. Ответ меняется на противоположный, когда складываются несколько условий:
- есть выделенная сеть от 10 Гбит/с, которая держит эту скорость устойчиво, а не в первую секунду теста;
- нод пять и больше, и потеря одной не съедает запас прочности хранилища целиком;
- допустимая потеря данных равна нулю на уровне дисков, а не отдельных баз;
- машины постоянно переезжают между нодами, и ожидание репликации мешает работе;
- есть человек, который будет Ceph сопровождать: разбираться с восстановлением после отказа диска, следить за заполнением, обновлять.
Последний пункт решает чаще остальных. Документация Ceph сама предупреждает: если большой узел отказывает, восстановление может переполнить оставшиеся диски, и кластер остановит работу, чтобы не потерять данные. С этим кто-то должен уметь работать до того, как это случится.
Чего я сознательно не делаю
- Не ставлю Ceph на сеть медленнее 10 Гбит/с. Рекомендация производителя здесь не перестраховка, а минимум.
- Не считаю реплику резервной копией. Реплика копирует ошибку вместе с данными.
- Не выставляю интервал репликации по умолчанию. Это ответ на вопрос о допустимой потере, и он задаётся тому, кто за эти данные отвечает.
- Не называю время восстановления, которое не замерял. Без прогона с секундомером это надежда, а не число.
- Не собираю эталонные образы ради двух–трёх хостов. Автоматизация установки должна окупаться.
- Не выдаю копию одной ноды за копию кластера. Конфигурация кластера, сети и служб сохраняется отдельно.
- Не выдаю прототип за работающую систему. Переписанное и развёрнутое разные вещи.
Стек
- Proxmox VE: кластер из трёх нод, репликация машин по расписанию.
- OpenZFS: локальные диски каждой ноды, снимки, передача разницы между снимками.
- Proxmox Backup Server: резервные копии на отдельный сервер.
- Syncthing: синхронизация файловых шар между узлами.
- Ansible: настройка нод и развёртывание всего перечисленного.
- Ceph и Packer: рассмотрены и сознательно не используются.
Почему это важно тому, кто платит
Распределённое хранилище выглядит бесплатным: оно ставится в той же панели, что и всё остальное, а диски уже куплены. Настоящая цена приходит позже и другими статьями: выделенная сеть от 10 Гбит/с со свитчем, второй кворум, который падает вместе с первым, и человек, который умеет восстанавливать Ceph после отказа диска. Для кластера из трёх нод эта цена обычно выше пользы.
Второй вывод касается не железа, а решения. Интервал репликации это число, которое определяет, сколько работы компания потеряет при отказе сервера. Его должен назвать тот, кто отвечает за эти данные, а не тот, кто настраивал хранилище. И третий: спрашивайте не «есть ли у нас резервные копии», а «когда мы последний раз из них восстанавливались». Ответ «ни разу» означает, что копий, возможно, нет.
Частые вопросы
Ceph или ZFS для кластера Proxmox из трёх нод?
Если между нодами нет выделенной сети от 10 Гбит/с, выбирайте репликацию ZFS. Ceph и Proxmox требуют такую сеть как минимум, а на трёх нодах у Ceph нет запаса на второй отказ. Цена ZFS в том, что репликация асинхронная и изменения после последней синхронизации при отказе ноды теряются.
Сколько данных теряется при репликации ZFS?
Всё, что изменилось после последней синхронизации. Минимальный интервал репликации в Proxmox одна минута, максимальный раз в неделю. Интервал нужно выбирать под допустимую потерю данных, а не оставлять значение по умолчанию.
Можно ли использовать реплику вместо резервной копии?
Нет. Реплика копирует текущее состояние вместе с ошибками: удалённый файл или испорченная база уйдут на соседнюю ноду при следующем запуске. Реплика защищает от отказа железа, резервная копия защищает от потери данных.
Хватит ли для Ceph полносвязной сети через Thunderbolt?
В моём случае нет. Линк согласовался на 20 Гбит/с по одной линии из двух, но устойчиво держал 0,94 Гбит/с при 6,6 в первую секунду. Для репликации ZFS по расписанию этого достаточно, для Ceph это в десять раз меньше рекомендованного минимума.
С какого размера кластера стоит переходить на Ceph?
Когда есть выделенная сеть от 10 Гбит/с, нод пять и больше, допустимая потеря данных на уровне дисков равна нулю и есть человек, который будет Ceph сопровождать. Последнее условие решает чаще остальных.
Нужен ли Packer для небольшого кластера?
Для двух–трёх хостов обычно нет. Шаблон образа окупается, когда машин много и они одинаковые. На малом парке достаточно файла автоматической установки в репозитории, настройки через Ansible и создания машин через Terraform.
Источники
- Требования Ceph к оборудованию: сеть не медленнее 10 Гбит/с, восстановление после отказа большого узла.
- Proxmox: гиперконвергентный кластер с Ceph: не меньше трёх серверов и выделенная сеть от 10 Гбит/с.
- Proxmox: полносвязная сеть для Ceph на кластерах от трёх до пяти нод.
- Proxmox: репликация хранилища: интервалы и потеря данных при отказе.
- Лицензия Packer: Business Source License.
Нужна консультация?
Если вы выбираете хранилище для своего кластера или хотите понять, что на самом деле защищают ваши реплики и копии, запишитесь на разговор. Разберём сеть, допустимую потерю данных и то, когда вы последний раз восстанавливались из копии. Смежные материалы: кластер Kubernetes на своих серверах, хранилище секретов на OpenBao.